IronWebScraper for .NET
Thư viện web scraping cho C# giúp mô phỏng hành vi duyệt web của người dùng để trích xuất nội dung, tệp và hình ảnh thành đối tượng .NET. Hỗ trợ JavaScript rendering, CSS Selector, XPath và chạy đa luồng nền.
- Bản quyền chính hãng
- Xuất hóa đơn VAT
Tương thích
Tính năng nổi bật
Viết một lớp web-scraper C# để xử lý hàng nghìn đến hàng triệu trang web.
Xuất dữ liệu thành instance class C#, JSON hoặc file tải xuống.
Mô phỏng hành vi duyệt web của người dùng bằng workflow tuyến tính trong C#.
Chạy mã như nhiều trình duyệt web ảo song song với cơ chế chịu lỗi.
Dùng CSS Selectors để nhận diện và xử lý từng loại trang.
Áp dụng XPath expressions cho các kịch bản trích xuất dữ liệu chi tiết.
Tùy biến hoàn toàn logic scraping bằng C# theo cấu trúc website.
Debug từng method và theo dõi trực tiếp trong Visual Studio.
Quản lý multithreading và yêu cầu web chạy nền cho hàng trăm thread đồng thời.
Thiết lập độ lịch sự (politeness) để giới hạn tốc độ request tới máy chủ đích.
Tạo một hoặc nhiều identity mô phỏng các phiên truy cập thực tế.
Gán User Agent, Cookies, Logins và IP addresses cho từng request.
Tự tạo request duy nhất từ URL, phân tích phương thức và biến post.
Replay request trước đó nhờ advanced caching mà không cần Internet.
Tự động lưu job scrape và tiếp tục lại sau ngoại lệ hoặc mất điện.
Cài qua NuGet trong Visual Studio hoặc dùng một DLL không dependency.
Tổng quan
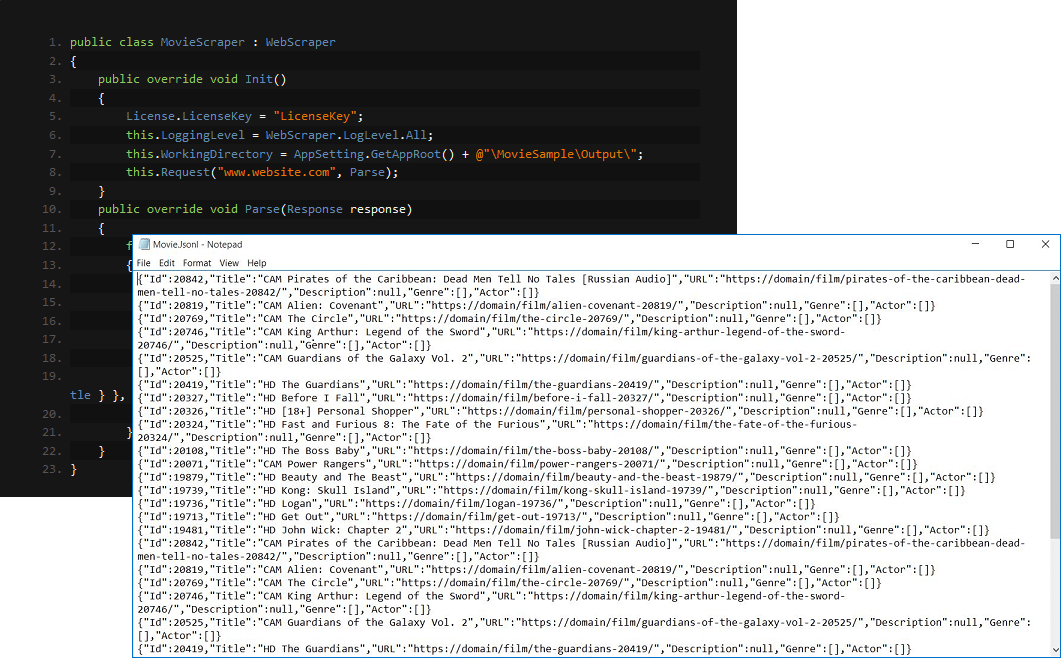
IronWebScraper for .NET tập trung vào bài toán thu thập dữ liệu web trong môi trường C#. Thư viện cho phép mô phỏng hành vi duyệt web của người dùng để lấy nội dung, tệp và hình ảnh từ ứng dụng web, sau đó chuyển thành các đối tượng .NET gốc.
Cách làm việc của thư viện xoay quanh một lớp web-scraper C# duy nhất. Từ lớp này, lập trình viên có thể xử lý số lượng lớn trang web và xuất dữ liệu thành các instance lớp C#, JSON hoặc tệp tải về, phù hợp với các quy trình tổng hợp dữ liệu và nghiên cứu thị trường.
Phù hợp cho
Thu thập dữ liệu phục vụ nghiên cứu thị trường.
Tổng hợp dữ liệu từ nhiều website vào hệ thống .NET.
Phân tích đối thủ cạnh tranh bằng dữ liệu web có cấu trúc.
Xây dựng quy trình scraping cần JavaScript rendering.
Triển khai tác vụ scraping song song với số lượng request lớn.
Ước tính chi phí
Chọn số developer để xem chi phí tham khảo.
Từ 5 developer trở lên thường có giá tốt hơn.
Thông số kỹ thuật
- Hãng
- Iron Software
- Phiên bản
- 2026.x
- Loại license
- Perpetual License
- Loại sản phẩm
- .NET web scraping library
- Môi trường phát triển
- Visual Studio, .NET, .NET Framework, .NET Core, .NET Standard, C#
- Framework hỗ trợ
- .NET 10, .NET 9, .NET 8, .NET 7, .NET 6, .NET 5, .NET Framework 4.5.2+, .NET Core 2.1+, .NET Standard 2.0+
- Phạm vi sản phẩm: thư viện web scraping .NET được thiết kế để trích xuất dữ liệu có cấu trúc từ website.
- Môi trường IDE được hỗ trợ: Visual Studio 2022, Visual Studio 2019, Visual Studio 2017, Visual Studio 2015, Visual Studio 2013, Visual Studio 2012, Visual Studio 2010.
- Tùy chọn cài đặt được nêu: cài từ NuGet trong Visual Studio hoặc tải DLL.
- Ghi chú gói: một DLL và không có dependency.
Câu hỏi thường gặp
Có hỗ trợ website dùng JavaScript không?
Có. IronWebScraper hỗ trợ JavaScript rendering cùng intelligent navigation và automated data collection.

IronSecureDoc
IronSecureDoc là REST API self-hosted cho bảo mật và tuân thủ PDF, hỗ trợ mã hóa, redaction, watermarking, digital signing và quản lý…

IronPrint for .NET
Thư viện in ấn cho .NET hỗ trợ in silent trên Windows, in qua hộp thoại và cấu hình giấy, DPI, lề, bản sao. Tương thích Windows, macOS, iOS…

IronWord for .NET
Thư viện C# xử lý DOCX cho .NET, dùng để tạo, chỉnh sửa và xử lý tài liệu Word mà không cần Microsoft Office hoặc Word Interop.
Chưa chắc phương án nào phù hợp?
Cho chúng tôi biết nền tảng bạn đang dùng và số developer — chúng tôi đề xuất phương án tối ưu chi phí.